
检测与评测
CMMLU
专为中文语境打造的大规模多任务语言理解评估基准
访问官网
github.com
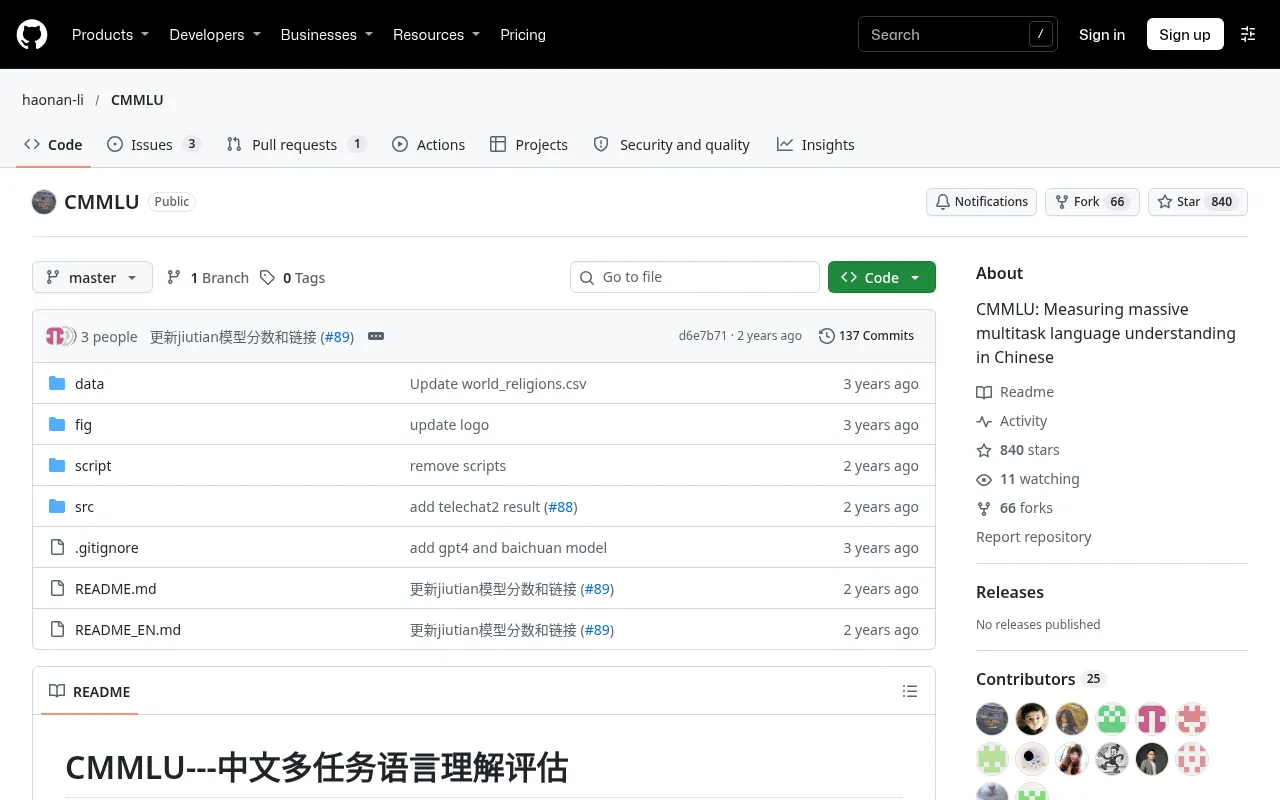
CMMLU是什么
CMMLU 是一个综合性的中文评估基准,专门用于评估大型语言模型在中文语境下的知识储备和推理能力。该基准由 haonan-li 等研究者开发,旨在填补现有评测工具在中文特定场景下的空白,提供更具本土化视角的性能衡量标准。
与通用评测不同,CMMLU 涵盖了从基础学科到高级专业水平的 67 个主题,包括需要复杂计算和推理的自然科学、依赖深厚知识的人文与社会科学,以及具有中国特色的生活常识(如中国驾驶规则)。许多任务包含中国特定的答案,使其成为完全中国化的测试基准。
该项目开源了数据集、评估脚本及详细的排行榜,支持 zero-shot 和 five-shot 等多种测试模式。研究人员和开发者可以通过 GitHub 仓库获取数据,验证模型在指令跟随能力及防数据污染方面的表现,从而更准确地评估模型在中文世界的实际应用能力。
主要功能
- 全面主题覆盖涵盖 67 个主题,从 STEM 到人文学科、社会科学及其他领域,全面考察模型的知识广度。
- 高度本土化包含大量中国特定答案的任务,如中国驾驶规则和本土文化常识,避免西方中心主义的偏差。
- 多层次难度题目设计跨越从基础学科知识到高级专业水平的推理需求,有效区分模型的能力层级。
- 多种测试模式支持 zero-shot 和 five-shot 等多种评估设置,提供灵活的模型性能测试方案。
- 严格数据验证对未开放公测的 API 模型进行指令跟随能力和数据污染验证,确保榜单结果的真实性。
- 开源透明所有数据、脚本和评估代码均在 GitHub 上公开,便于社区复现结果和进行二次开发。
如何使用
- 访问 CMMLU 的 GitHub 官方仓库页面。
- 浏览 README 文件了解基准的详细结构和主题分类。
- 下载数据集文件夹中的评估数据。
- 使用提供的 src 或 script 目录中的代码运行评估脚本。
- 对比模型在 zero-shot 或 five-shot 模式下的得分与官方排行榜。
- 如需古汉语评估,可参考项目中提到的 ACLUE 基准。
应用场景
- 模型研发评估AI 研发团队使用 CMMLU 量化新模型在中文语境下的知识理解和推理能力提升情况。
- 学术基准研究研究人员利用该基准分析不同架构模型在处理中国特定任务时的表现差异。
- 行业应用选型企业通过查看排行榜,选择在人文、社科或本地常识方面表现优异的模型用于具体业务。
价格 / 免费额度
CMMLU 是开源项目,数据集和代码可免费获取。以官网为准。
适合人群
- 大语言模型研究人员
- AI 算法工程师
- 自然语言处理学者
- 中文 AI 应用开发者
常见问题
CMMLU 主要评估哪些能力?
主要评估语言模型在中文语境下的知识储备和推理能力,涵盖自然科学、人文社科及中国特定常识。
如何确保榜单模型的真实性?
对于未开放公测的 API 模型,项目组会验证其基本指令跟随能力并检查是否存在数据污染,通过验证后才会更新榜单。
如果需要评估古汉语能力怎么办?
CMMLU 主要针对现代中文,如果有古汉语评估需求,官方建议使用 ACLUE 基准。
支持哪些测试模式?
官方排行榜展示了模型在 five-shot 和 zero-shot 测试下的表现,用户也可自行配置其他模式。